
Die Redaktion präsentiert jeden Dienstag die Geschichten, die sie bewegt, aufgerüttelt oder zum Nachdenken angeregt hat. Heute u. a. mit mehr KI als nächste Woche. Versprochen!
KI-Hype: Die Zusammenfassung
Es hat funktioniert. Ganz viele Leute haben über die Gefahren von KI gehört und hatten viele Fragen. Viele Fragen sind auch bei uns gelandet. Deshalb hier ein Versuch, einige der Erklärungen und Hintergründe gesammelt zu präsentieren.
Zuerst einmal zur KI und ihrer angeblichen Schuldfrage: Es wurde viel berichtet, dass die KI-Agenten zu Schurken, also böse, geworden wären („gone rogue“). Grosse Sprachmodelle und damit die auf ihnen aufsetzenden KI-Agenten sind darauf trainiert, die ihnen gestellten Probleme zu lösen und dabei möglichst viele Möglichkeiten auszuprobieren, bis das gewünschte Resultat erreicht ist. Sie können nicht „die Seite wechseln“ oder irgendetwas anderes tun, was wir ihnen in vermenschlichender Weise andichten. Die Trainings basieren auf einer Rückkoppelung, die dann als erfolgreich gewertet wird, wenn die richtige Antwort irgendwo vorkommt. Irgendwann kommt vielleicht das richtige Resultat heraus. Vielleicht aber auch nicht. Ganz besonders nicht, wenn viele der Probleme scheinbar unlösbar sind.
KI-Systeme, egal ob sie jetzt als „Superintelligenz“ bezeichnet werden oder nicht, sind nicht schuldfähig. Das Konzept von „Schuld“ ist nur für Menschen definiert. Sowohl aus dem ethischen wie auch aus dem juristischen Blickwinkel.
Hier noch die versprochene Zusammenfassung der Reaktionen auf die Entschuldigungsversuche der KI-Chefs:
- Hype und Criti-Hype: Wer kennt nicht den Marketingspruch «Es gibt keine schlechte Publicity»? Denn auch Aufbauschen mit negativen Schlagzeilen hilft beim Aufbau der Marke. Entsprechend kann es gut sein, dass die Firmenchefs sich hier einfach ein Kräftemessen in Schlagzeilen liefern.
- Verantwortung oder nicht: Es ist erstaunlich, dass hoch-experimentelle KI-Systeme über Wochen Zugang zum Internet hatten und scheinbar niemand deren Internetzugang oder die sonstigen Aktivitäten dieser KI-Agenten beobachtet hat. In anderen Disziplinen würde man für solche Verantwortungslosigkeit gefeuert. Bisher schaffen es die Firmen aber, sich aus der Verantwortung zu ziehen, obwohl die aktuellen „Wildwest“-ähnlichen Aktivitäten der KI-Firmen juristische Fragen aufwerfen. Aber Big-Tech-Firmen haben sich in den letzten Jahren darin perfektioniert, jegliche Verantwortung von sich abprallen zu lassen. Ach ja: Die Webseite „Felony Bench“ (in etwa: „Benchmark der Verbrechen“) versucht, dieser Statistik der KI-Hackereien eine ironische Note abzugewinnen.
- Gesetze prägen: Vielleicht geht es aber auch darum, mit dem aktuellen Vorpreschen der grossen KI-Firmen, die Gesetzgebung rund um KI in die eigene Hand zu nehmen, wie Reto Vogt am Freitag in seiner Kolumne prognostizierte. Und sie so für sich einseitig möglichst gut zu gestalten (und vielleicht auch gleichzeitig ihren Vorsprung zu zementieren).
- Gier: Samuel Buchmann erklärt, dass die Chefs der KI-Firmen trotzdem Gründe zum Weitermachen haben. Weil sie oder ihre Firmen sonst kein (zusätzliches) Geld mehr bekommen.
In den Artikeln der vergangenen Woche sieht man also sehr wenig „KI-Chefs haben Gefahr erkannt und bannen sie jetzt gemeinsam“. Im Gegenteil. Solange sie die Verantwortung wie bis anhin von sich abwenden können und sich vielleicht sogar mit Gesetzen noch besser vor solchen Verantwortungsfragen schützen können, werden sie weiter Geld verdienen. Und die daraus entstehenden Kosten und Risiken auf den Rest der Menschheit abwälzen.
„KI wird die Menschheit nicht zerstören,“ sagt Kara Swisher in einem insgesamt sehr lesenswerten Interview, „sondern die Menschen dahinter.“ („AI isn’t going to destroy humanity–but the people building it might.“)
KI-Tools sind hilfreich. Aber wie alle Werkzeuge, die der Mensch geschaffen hat, haben sie auch Risiken. Schön sieht man das am Küchen- oder Taschenmesser: Zu Millionen liegen die in Haushalten herum oder werden herumgetragen; gleichzeitig gelten sind als zu gefährlich, um in Flugzeuge mitgenommen zu werden. Analog dazu braucht es gesetzliche Regelungen, wann solche Systeme als unbedenklich gelten und in welchen Einsatzfeldern sie einfach zu gefährlich sind. Am besten evidenzbasiert, wie Marcel Salathé betont. Es ist immer schwierig, auf Gesetzesebene alle Möglichkeiten vorherzusehen, was genau schief gehen kann, nicht nur in dynamischen Feldern wie hier. Deshalb muss vor allem definiert werden, wer schuld ist, wenn etwas schiefgeht, genau gleich, wie auch im restlichen Leben. Unabhängig von den PR- und Lobby-Aktivitäten der KI-Firmen.
KI-Agent 007, mit der Lizenz zum Mist bauen
Nicht nur KI-Systemen an sich kennen oft keine Schranken und hacken sich in Drittsysteme ein, auch die als Helfer angepriesenen Agenten (egal ob im Browser integriert oder als eigenständige Applikation verfügbar) neigen zu teilweise massivem Fehlverhalten. Wenn man sich vor Augen führt, wie heutige KI funktioniert und dass die eingesetzten Modelle schon rein prinzipbedingt zu Halluzinationen neigen, dann ist das nicht weiter überraschend. Nichtsdestotrotz lassen sich viele von den Marketing-Versprechen der Anbieter blenden und geben KI-Agenten umfangreiche Zugriffsrechte auf die eigenen Daten und Computer.
Auf Threads zu lesen war am Wochenende der Fall eines Benutzers, welcher Muse (den KI-Agenten von Meta/Facebook) mit der Beantwortung von Käuferanfragen zu seinen im Facebook-Marktplatz eingestellten Artikel beauftragt hatte. Der Agent verhandelte mit einem potenziellen Käufer nicht nur einen viel zu tiefen Preis, er gab auch noch die Wohnadresse des Benutzers preis und vereinbarte einen Abholtermin. Dies alles, ohne den Benutzer zu fragen oder nur schon zu informieren. Der Verkauf schlug daher nicht nur fehl, der enttäuschte Kaufwillige hinterliess auch gleich noch einen negativen Review.
Meta würde jetzt vermutlich argumentieren, dass es am Benutzer sei, die Agenten so anzuleiten, dass sie nicht über die Stränge schlagen. Aber man kann sich zu Recht fragen, inwiefern ein Produkt, welches ohne intensive Steuerung und fokussierte Prompts seinen Zweck (dem Benutzer zu helfen und zu entlasten) nicht erfüllen kann, nicht schlicht von Grund auf defekt ist.
KI ersetzt Websuche
Zur oft geäusserten Vermutung, dass ChatGPT und co. die neuen Suchmaschinen sind und Menschen vermehrt „die KI“ fragen anstatt selber im Web zu surfen, gibt es jetzt Webzugriffs-Messungen von Nachrichtenseiten. Demnach ist die Zahl der Zugriffe auf US-Nachrichtenseiten von 70 Mio/Monat Ende 2024 auf knapp 50 Mio/Monat im Juli 2026 zurückgegangen. Dies hat nicht nur Auswirkungen auf die heute oft werbebasierte Finanzierung von Nachrichtenportalen, sondern auch auf Qualität der Informationen, welche News-Interessierte erhalten. Wenn mehrseitige Zeitungsartikel durch KI-Modelle auf wenige Punkte hinunterkondensiert werden, gehen notwendigerweise wichtige Aspekte und Details verloren.
Geschäftsmodell KI-Diagnose-Pimping
KI scheint in den USA sehr lukrativ zu sein – für Krankenhäuser. So hat eine Auswertung von 34 Krankenversicherern ergeben, dass 2024 und 2025 Krankenhäuser im Vergleich zum Vorjahr die gleichen Behandlungen zu höheren Kosten abgerechnet wurden, weil mehr Codes für höheren Schweregrad eingegeben wurden.
Der Krankenkassenverband geht davon aus, dass die Krankenhäuser „dank“ dem Einsatz von KI-Analysen und -Kostenmaximierung rund eine Milliarde mehr verrechnet hätten, ohne mehr Leistung zu liefern, wie t3n zusammenfasst.
Geschäftsmodell KI-Chip-Lagerung?
Hyperscaler und ihre Geschäftspartner hätten GPU-Chips und Karten gekauft, könnten sie aber gar nicht einsetzen. So zumindest hört sich das an, was Ed Zitron zusammengetragen hat. Er hat sich aus diversen Firmenreports und den dazugehörigen Diskussionen mit Investoren einiges zusammengereimt. Aufgefallen ist dabei, dass die Antworten sehr ausweichend werden, wenn es um konkrete Zahlen zu KI-Datenzentren und -Chips geht, viel unklarer, als wenn sie um den Ausbau von Datenzentren überhaupt reden (also inklusive dem, was „klassisch“ unter Cloud verstanden wird).
Wieso?
Nichts Genaues weiss man nicht. Wir aber alle wissen, dass Computer und ihre Innereien im Normalfall über wenige Jahren abgeschrieben werden. Wahrscheinlich werden die für KI-LLM-Anwendungen wie ChatGPT, Gemini oder Copilot verwendeten GPUs noch schneller abgeschrieben als die Computer auf unseren Schreibtischen. Und trotzdem scheint es sich für Google, Meta, Oracle und viele andere zu lohnen, jetzt Chips zu kaufen, obwohl sie noch nicht eingebaut werden können. Unter anderem, weil die Datenzentren dazu noch gar nicht gebaut sind.
Ed Zitron geht davon aus, dass KI-Chips für mehrere hundert Milliarden Dollar unbenutzt irgendwo gelagert werden. Zitron sieht keine andere Erklärung, als dass hier ganz viel spekuliert wird. Zugunsten sowohl von von den Hyperscalern selbst, die so lange wie möglich als dauernde „Growth Company“ angesehen werden sollen, was ihrem Börsenkurs stützt (und weshalb sie sehr hohe Ressourcen-Prognosen abgeben).
Für uns Kunden aber bedeutet das, dass die Preise für RAM-Speicher- und Flash-Chips sich seit einem Jahr verdoppelt bis verdreifacht haben, wenn wir diese kaufen wollen. Obwohl gleichzeitig Speicherchips für unzählige Milliarden auf den GPU-Boards vor sich hin dösen und an Wert verlieren.
Google besteht auf Youtube-Tracking
Google sammelt Daten. Viele Daten. So viele, dass schon vor vielen Jahren gewitzelt wurde, dass Google mehr über Personen wisse, als deren Lebenspartner:innen. Nicht alle Menschen wollen ihre persönlichsten Daten kampflos Google übergeben und haben deshalb von ihrem – auch im Gesetz vorgesehenen – Recht Gebrauch gemacht, nur die nötigsten Daten mit Google zu Teilen, während sie Youtube-Videos schauen. Also, auf unnötiges Tracking zu verzichten.
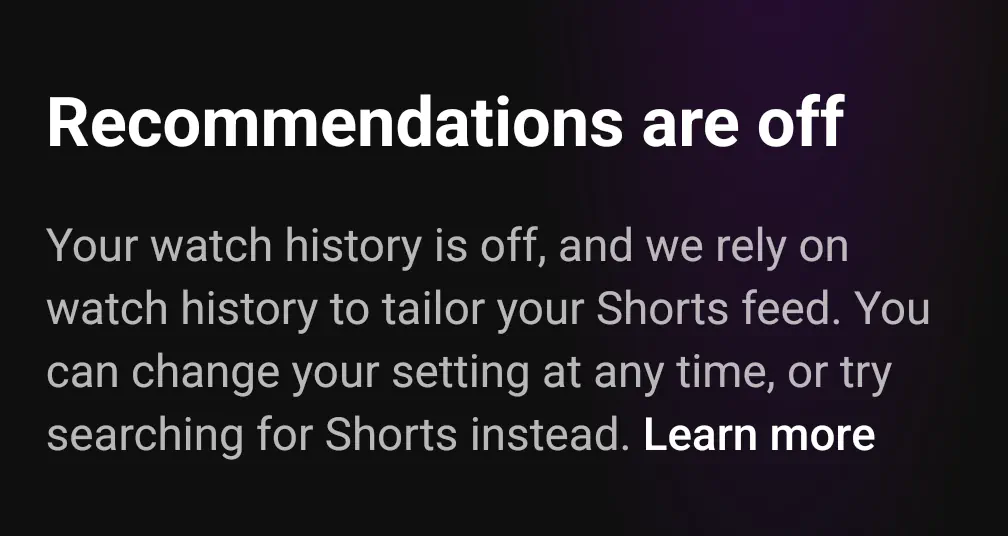
Google scheint nun begonnen zu haben, diese Personen im Gegenzug so lange mit untenstehender Nachricht zu „motivieren“, bis sie Tracking „freiwillig“ wieder einschalten.
Zumindest gibt es einige Situationen, in denen Personen darüber berichten, dass sie keine Empfehlungen mehr bekommen hätten, stattdessen diese Nachricht. Und die Online-Empfehlungen lauten Unisono: „Schalte einfach deine Video-Historie ein, dann geht die Meldung weg“. Übrigens ebenfalls ausschliesslich in Youtube-Shorts …
Und schliesslich:
- Die Schweizer E-ID lässt bekanntlich noch auf sich warten. Wer es eilig hat (und/oder eine EU-kompatible E-ID braucht), kann sich eine solche in Liechtenstein holen. Liechtensteinische Staatsbürgerschaft ist dazu keine Voraussetzung, es braucht aber einen Ausflug nach Vaduz zum dortigen Ausländer- und Passamt. Die Details beschreibt Martin Steiger in seinem Blog.
- «Bei Microsoft wurde das unerlaubte Abgreifen von Millionen urheberrechtsgeschützter Texte als „erstaunlicher Diebstahl von beispiellosem Umfang“ und womöglich „größter Diebstahl von Arbeitskraft in der Geschichte der Menschheit“ bezeichnet», schreibt Heise.
- Die Chatkontrolle-Versuche gehen in die nächste Runde.